library(tidyverse)
library(FrF2)
library(broom)
library(flextable)Diseño factorial fraccionado \(2^{k-p}_{R}\) en R
Librerías
Al inicio de todas las clase se colocarán las librerías que se van a utilizar para el desarrollo de los casos.
Introducción
Un diseño factorial fraccionado de dos niveles permite estudiar muchos factores con un número reducido de corridas experimentales. En lugar de ejecutar todas las combinaciones (\(2^k\)), se toma una fracción que mantiene propiedades de ortogonalidad y resolución.
Diseño
Vamos a diseñar el mismo experimento de la presentación
\(2^{6-3}_{III}\)
diseno <- FrF2::FrF2(nfactors = 6, nruns = 8,
                     generators = c("AB", "AC", "BC"),
                     randomize = FALSE)

attr(diseno, "design.info")
$type
[1] "FrF2.generators"
$nruns
[1] 8
$nfactors
[1] 6
$factor.names
$factor.names$A
[1] -1 1
$factor.names$B
[1] -1 1
$factor.names$C
[1] -1 1
$factor.names$D
[1] -1 1
$factor.names$E
[1] -1 1
$factor.names$F
[1] -1 1
$generators
[1] "D=AB" "E=AC" "F=BC"
$aliased
$aliased$legend
[1] "A=A" "B=B" "C=C" "D=D" "E=E" "F=F"
$aliased$main
[1] "A=BD=CE" "B=AD=CF" "C=AE=BF" "D=AB=EF" "E=AC=DF" "F=BC=DE"
$aliased$fi2
[1] "AF=BE=CD"
$FrF2.version
[1] "2.3-5"
$replications
[1] 1
$repeat.only
[1] FALSE
$randomize
[1] FALSE
$seed
NULL
$creator
FrF2::FrF2(nfactors = 6, nruns = 8, generators = c("AB", "AC",
"BC"), randomize = FALSE)Análisis
Podemos agregar una respuesta simulada
R <- rnorm(8, 30, 2)

resultados <- cbind(diseno, R)
Y analizarlo en consecuencia
modelo1 <- lm(R ~ A*B*C*D*E*F,
              data = resultados)

broom::tidy(modelo1) %>%
  dplyr::mutate(across(where(is.numeric), ~ round(., 2))) %>%
  flextable::flextable()
term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
(Intercept) | 30.35 | |||
A1 | 0.25 | |||
B1 | -0.97 | |||
C1 | -0.48 | |||
D1 | -0.62 | |||
E1 | 1.24 | |||
F1 | 1.08 | |||
A1:B1 | ||||
A1:C1 | ||||
B1:C1 | ||||
A1:D1 | ||||
B1:D1 | ||||
C1:D1 | 0.13 | |||
A1:E1 | ||||
B1:E1 | ||||
C1:E1 | ||||
D1:E1 | ||||
A1:F1 | ||||
B1:F1 | ||||
C1:F1 | ||||
D1:F1 | ||||
E1:F1 | ||||
A1:B1:C1 | ||||
A1:B1:D1 | ||||
A1:C1:D1 | ||||
B1:C1:D1 | ||||
A1:B1:E1 | ||||
A1:C1:E1 | ||||
B1:C1:E1 | ||||
A1:D1:E1 | ||||
B1:D1:E1 | ||||
C1:D1:E1 | ||||
A1:B1:F1 | ||||
A1:C1:F1 | ||||
B1:C1:F1 | ||||
A1:D1:F1 | ||||
B1:D1:F1 | ||||
C1:D1:F1 | ||||
A1:E1:F1 | ||||
B1:E1:F1 | ||||
C1:E1:F1 | ||||
D1:E1:F1 | ||||
A1:B1:C1:D1 | ||||
A1:B1:C1:E1 | ||||
A1:B1:D1:E1 | ||||
A1:C1:D1:E1 | ||||
B1:C1:D1:E1 | ||||
A1:B1:C1:F1 | ||||
A1:B1:D1:F1 | ||||
A1:C1:D1:F1 | ||||
B1:C1:D1:F1 | ||||
A1:B1:E1:F1 | ||||
A1:C1:E1:F1 | ||||
B1:C1:E1:F1 | ||||
A1:D1:E1:F1 | ||||
B1:D1:E1:F1 | ||||
C1:D1:E1:F1 | ||||
A1:B1:C1:D1:E1 | ||||
A1:B1:C1:D1:F1 | ||||
A1:B1:C1:E1:F1 | ||||
A1:B1:D1:E1:F1 | ||||
A1:C1:D1:E1:F1 | ||||
B1:C1:D1:E1:F1 | ||||
A1:B1:C1:D1:E1:F1 |
broom::tidy(aov(modelo1)) %>%
  dplyr::mutate(across(where(is.numeric), ~ round(., 2))) %>%
  flextable::flextable()
term | df | sumsq | meansq |
|---|---|---|---|
A | 1 | 0.51 | 0.51 |
B | 1 | 7.45 | 7.45 |
C | 1 | 1.86 | 1.86 |
D | 1 | 3.07 | 3.07 |
E | 1 | 12.23 | 12.23 |
F | 1 | 9.38 | 9.38 |
C:D | 1 | 0.14 | 0.14 |
Como se ve, no se estiman muchos efectos, no tenemos grados de libertad.
Si queremos ver una salida más limpia, podemos hacer lo siguiente:
broom::tidy(modelo1) %>%
  dplyr::mutate(across(where(is.numeric), ~ round(., 2))) %>%
  tidyr::drop_na(estimate) %>%
  flextable::flextable()
term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
(Intercept) | 30.35 | |||
A1 | 0.25 | |||
B1 | -0.97 | |||
C1 | -0.48 | |||
D1 | -0.62 | |||
E1 | 1.24 | |||
F1 | 1.08 | |||
C1:D1 | 0.13 |
Nótese que se está estimando C:D en lugar de A:F, estos detalles son importantes de revisar en la estructura de ALIAS.
Algunos gráficos
FrF2::DanielPlot(modelo1) # gráfico de daniel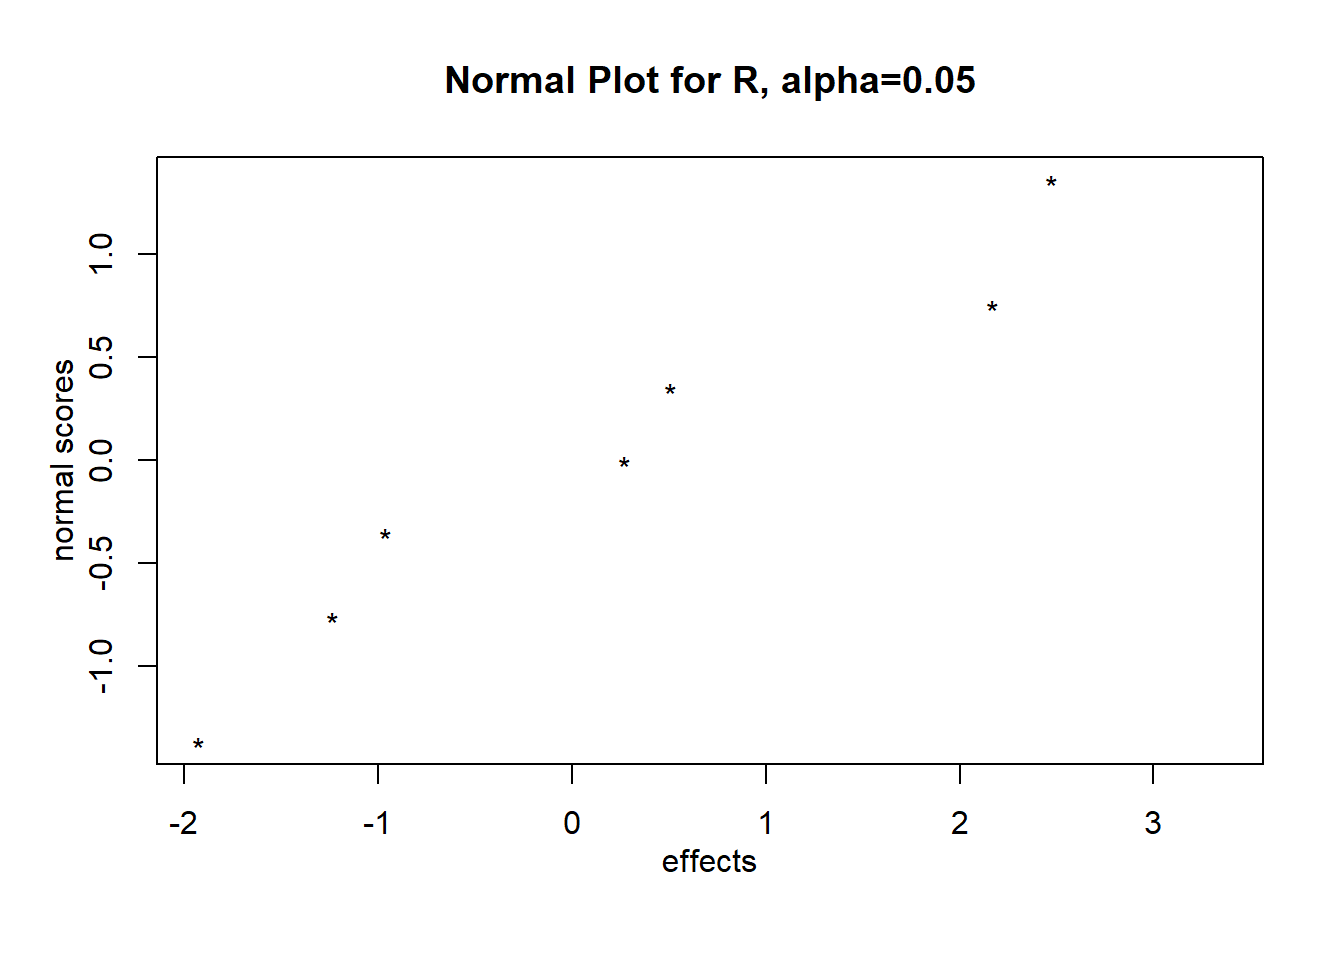
FrF2::MEPlot(modelo1) # Efectos principales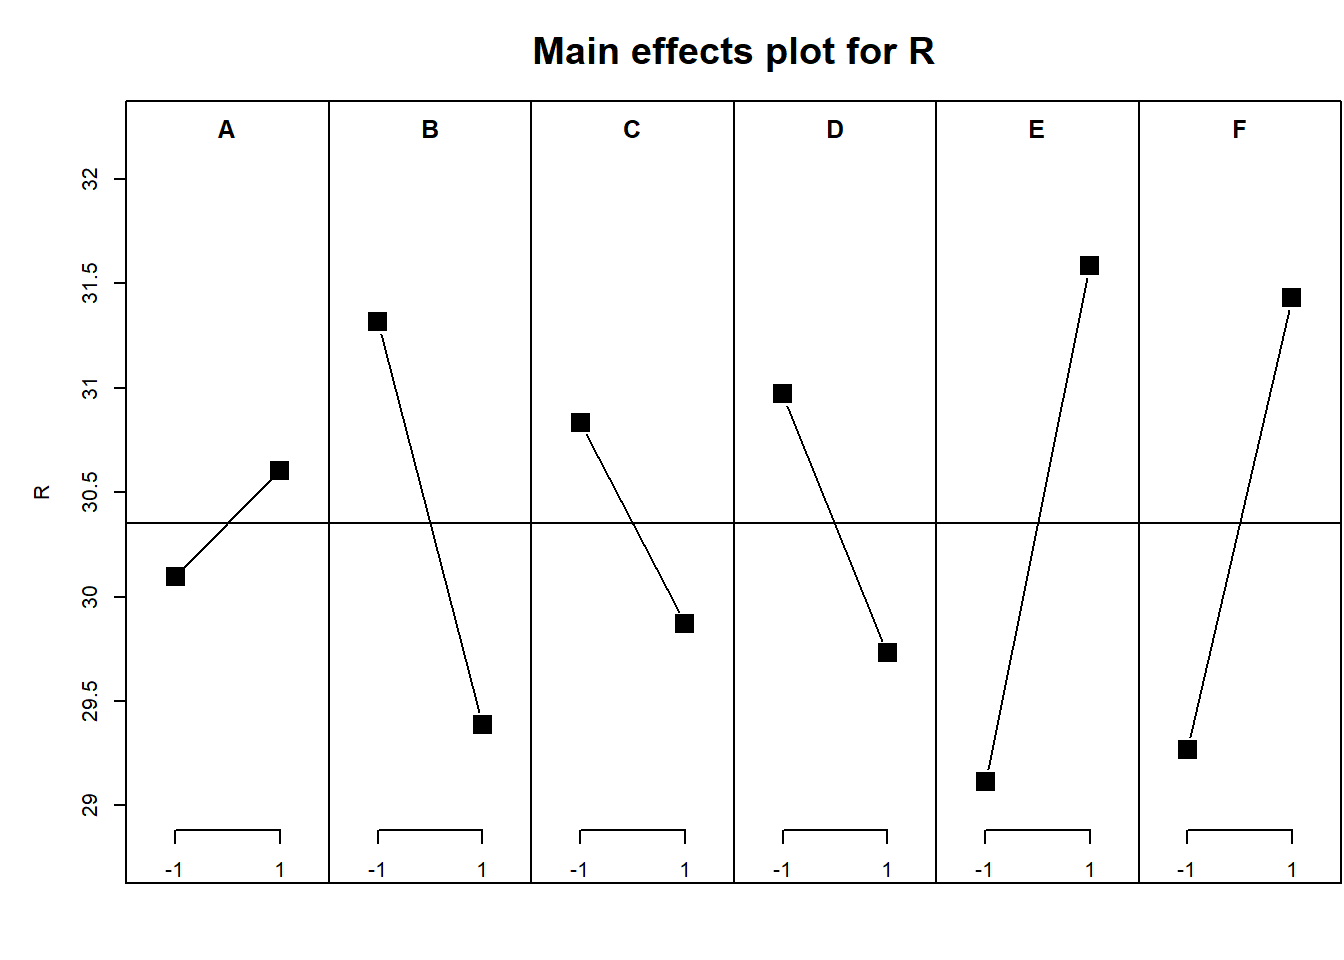
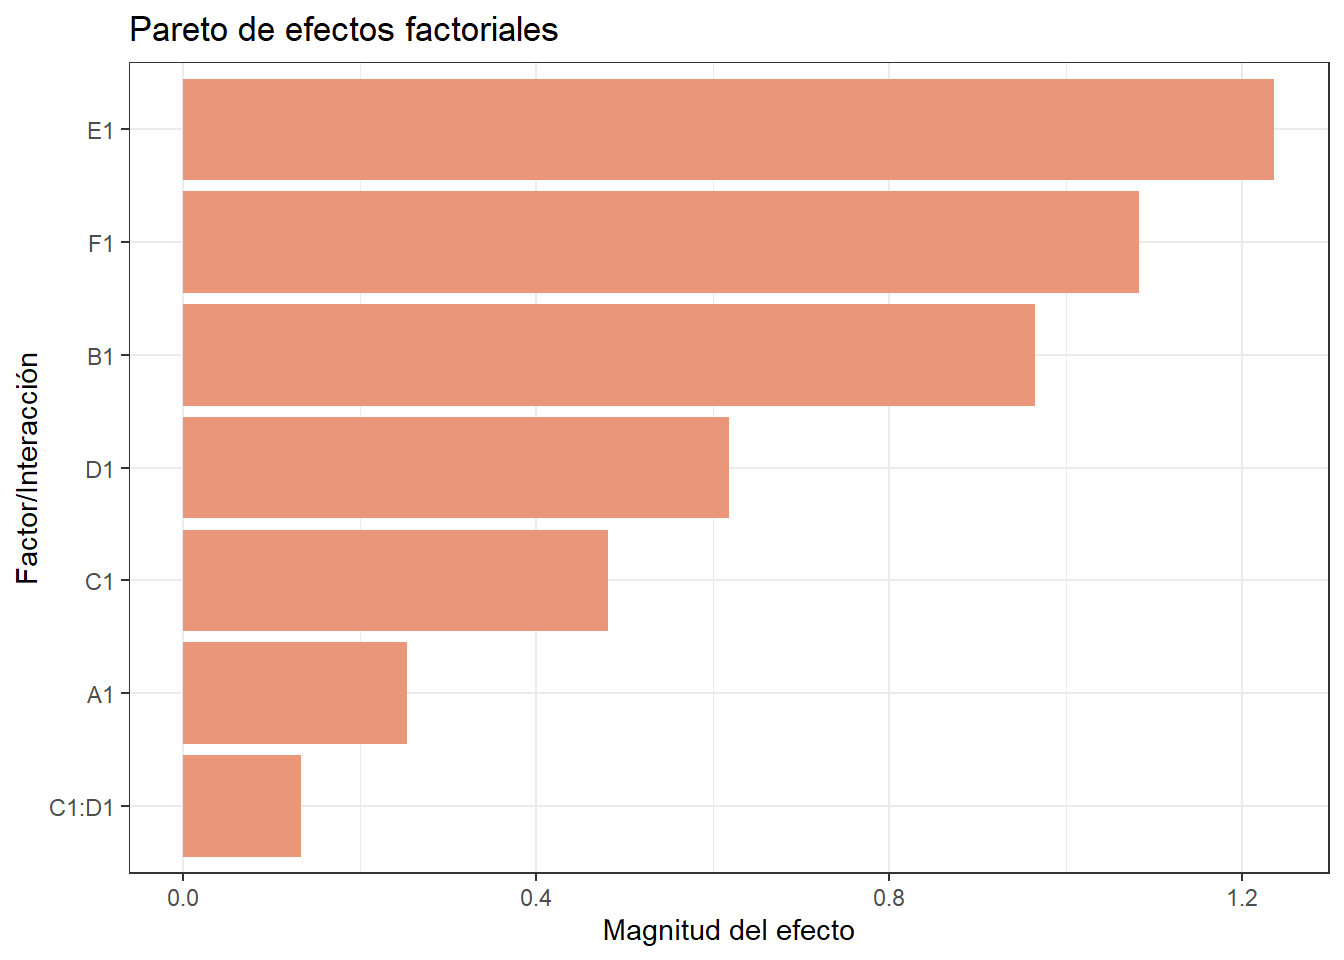
#FrF2::IAPlot(modelo1) # Efectos de interacciónPara un gráfico de Pareto
efectos <- coef(modelo1)[-1]  # quitamos intercepto
df_efectos <- data.frame(
  factor = names(efectos),
  efecto = abs(efectos)) %>%
  tidyr::drop_na()

ggplot(df_efectos, aes(x = reorder(factor, efecto), y = efecto)) +
  geom_bar(stat = "identity", fill =  "darksalmon") +
  coord_flip() +
  labs(x = "Factor/Interacción", y = "Magnitud del efecto",
       title = "Pareto de efectos factoriales") +
  theme_bw()